


Agent の能力から日常の使いやすさへ:MuseWork を支える設計原則
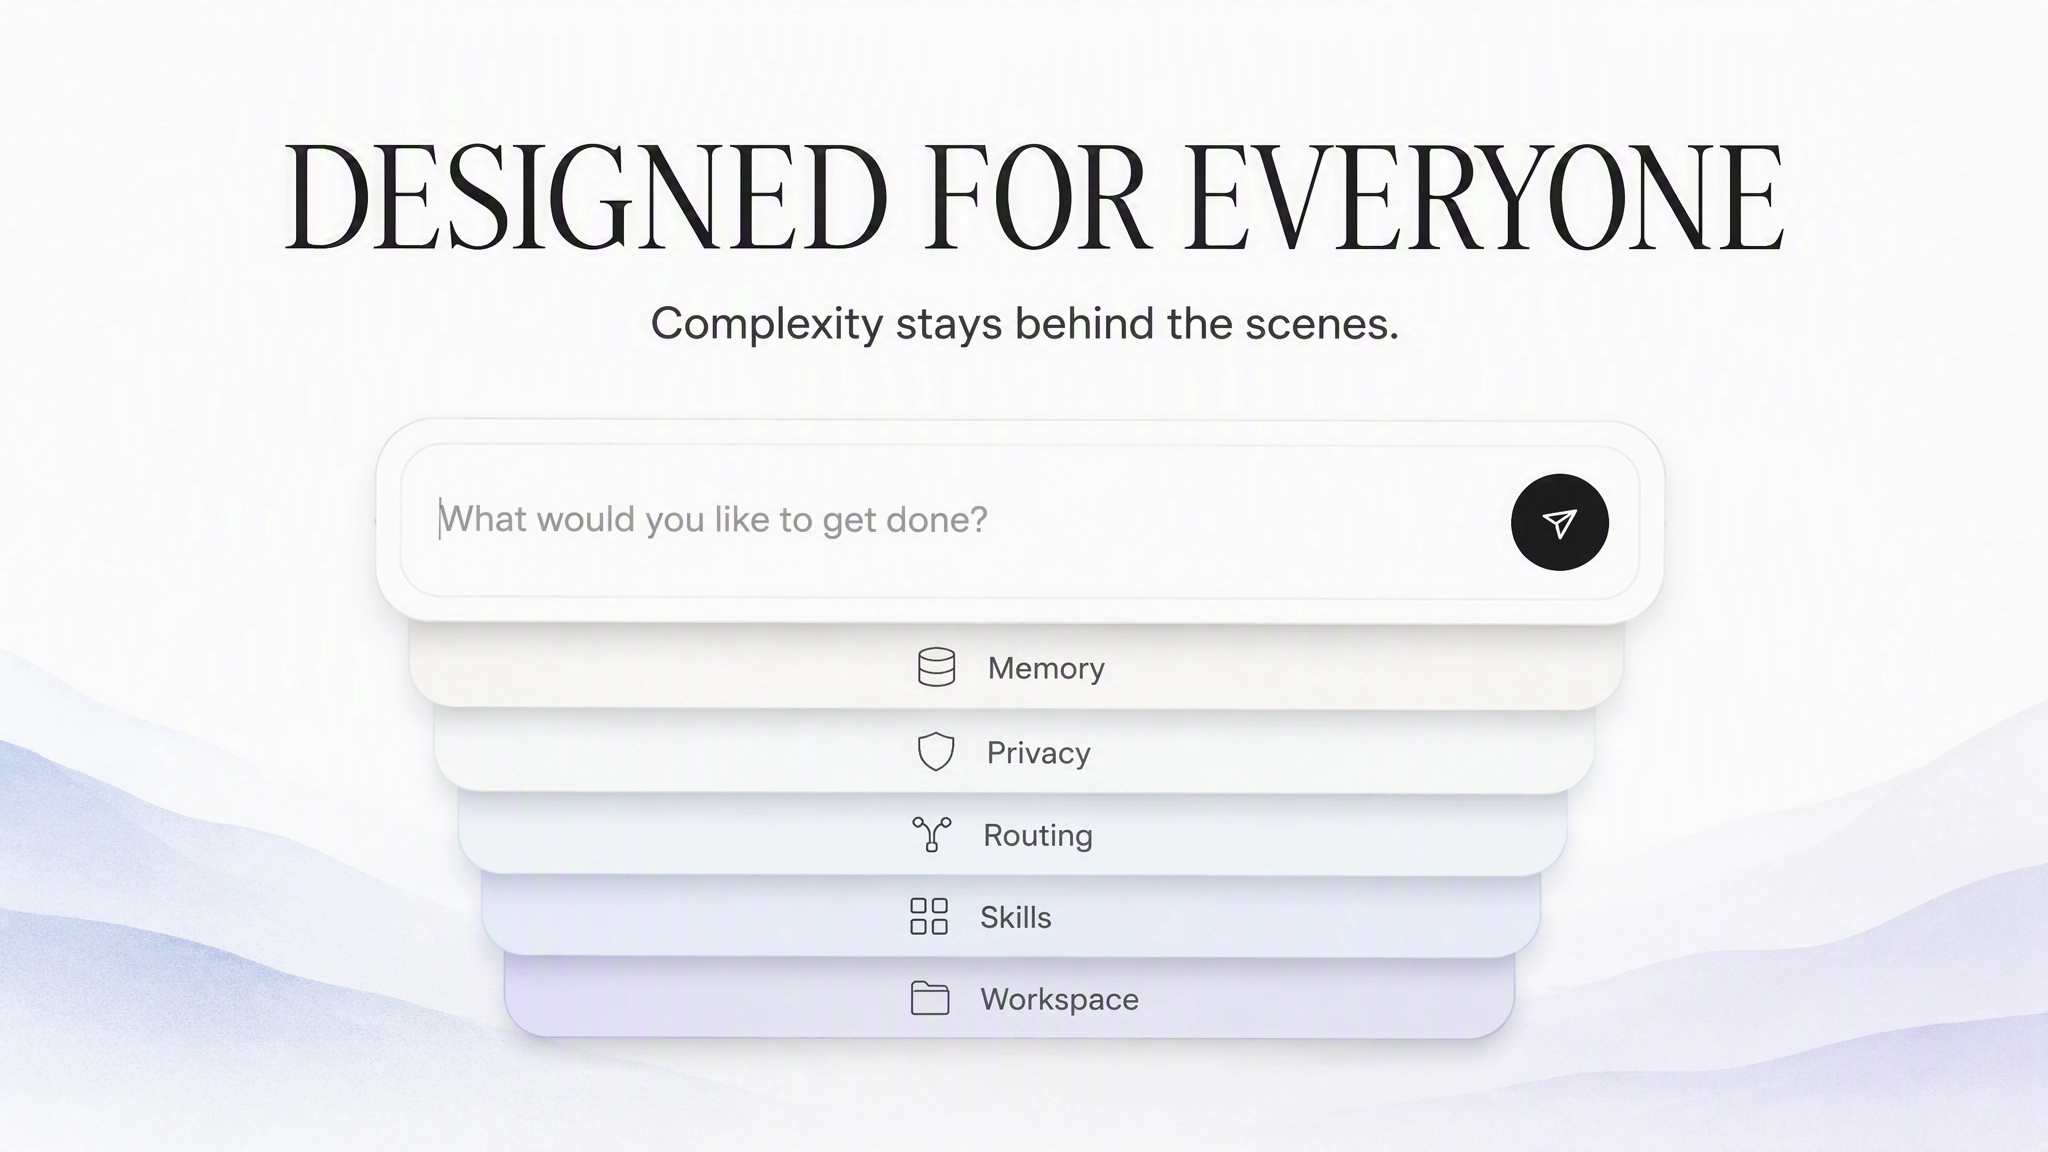
MuseWork の目標は、Agent 技術の複雑さを見せることではなく、誰もが自然に AI を使えるようにすることです。
この一年、OpenClaw や Hermes Agent などの製品は、Agent がコードを書き、ブラウザを操作し、ツールを呼び出し、ファイルを管理できることを示してきました。さらに、長期的な協働を通じてスキルや記憶を蓄積することもできます。こうした試みは、Agent の能力の限界を大きく押し広げました。
しかし一般のユーザーが Agent 製品を初めて開いたとき、目にするのは能力よりも、API キー、モデル選択、権限設定、プラグインのインストール、ワークフロー、トークン、VM といった障壁であることが少なくありません。
AI を使い始める前に、AI に行く手を阻まれてしまうのです。
MuseWork が答えたいのは、サービスのデプロイも、プロンプトの書き方も、モデルの仕組みも、Agent の知識も持たない人が、本当に役立つ AI アシスタントを手にできるのか、という問いです。
私たちは、できると考えています。AI に詳しいかどうかで、その恩恵を受けられるかどうかが決まるべきではありません。
I. ゼロ設定:会話を入り口にする
MuseWorkは、最初に設定作業を求めません。初めて開いたときから、必要なことをそのまま伝えるだけで使い始められます。
裏側では、Agent の初期化、ワークスペースの割り当て、スキルの読み込み、長期記憶の準備、セッションの振り分けをシステムが処理します。ユーザーが Agent を作成したり、モデルを選んだり、プラグインを入れたり、コンテキストウィンドウを理解したりする必要はありません。
最初のメッセージを送る前に、システムの概念を理解させるべきではありません。
会話そのものが入り口です。メッセージを送れば始まり、話を続ければコンテキストが加わります。話題を変えたときは、新しいコンテキストを開くべきかをシステムが判断します。以前の仕事に戻れば、MuseWork がそれまでのコンテキストを引き継ぎます。
裏側ではセッションの解析や複数チャネルの連携が動いていますが、その複雑さをユーザーに意識させるべきではありません。「今いるセッションは正しいか」ではなく、「MuseWork に何をしてほしいか」だけを考えられる体験が必要です。
II. 自然なやり取り:割り込み、追加、話題の転換を受け止める
実際の会話は、厳密な待ち行列どおりには進みません。作業の途中で「グラフも入れて」と付け加えたり、「止めて」と伝えたり、突然別の質問をしたりすることもあります。
MuseWorkは、そのメッセージが現在のタスクを中止するものか、依頼を補足するものか、新しいタスクとして待機させるものか、それとも独立した会話なのかを判断します。状態管理はシステムが担うべきで、ユーザーの負担にしてはいけません。
チャネルを変えただけで、ユーザーが同じ説明を繰り返す必要もありません。Web、Telegram、WeChat は、話しかける窓口が違うだけです。その先にいるのは、同じ Agent、同じスキル、同じ記憶を持つ存在であるべきです。
チャネルごとに別の「人」になってはいけません。どこで話しても MuseWorkは MuseWork です。
III. コスト:もっと気軽に会話できるようにする
メッセージを送るたびに費用を計算しなければならないなら、AI は日常の道具にはなりにくいでしょう。優れたアシスタントとは、ユーザーが気軽に反復し、修正し、質問できる存在です。
だからこそ、コストの最適化はビジネス上の課題であるだけでなく、体験の課題でもあります。
MuseWorkは、次の三つに取り組んでいます。
- 安定した内容をキャッシュする。 システムプロンプト、ツール定義、スキル説明の順序を安定させ、モデルが一度読んだ内容を何度も処理しないようにします。
- コンテキストを段階的に圧縮する。 画像、ツールの返り値、Web コンテンツ、ログ、長い会話を、協働を続けるために本当に必要な情報へ絞り込みます。
- 実行環境を必要なときだけ起動する。 通常の会話は軽量に保ち、コードの実行、ファイル処理、成果物の生成が必要なときだけ、より重い実行環境を立ち上げます。
システムの重複作業に対して、ユーザーに費用を負担させるべきではありません。
IV. プライバシー:約束だけに頼らない
ファイル、アカウント、カレンダー、メール、長期的な好みを AI に預ける以上、プライバシーを心配するのは当然です。本当に信頼できる設計は、約束を信じるよう求めるのではなく、アクセスすべきでないものにシステム上アクセスしにくくします。
MuseWorkは分離を標準としています。ユーザーごとに独立したワークスペースを持ち、ファイルは本人のクラウドストレージ領域に保存します。実行環境がアクセスできるのは許可されたディレクトリだけです。長期記憶は実行環境に散在させず、必要なときにサーバーから注入します。
外部サービスの認証トークンは暗号化します。アクセス経路には本人確認、所有権の確認、有効期限、レート制限、監査ログを設けます。一時的なファイルリンクは、発行前に所有権を確認し、自動的に失効します。
プライバシー保護はマーケティング上のラベルではなく、システム設計の基本姿勢です。
V. 記憶:優れたアシスタントは、毎回あなたを一から学び直さない
多くの AI 製品で特に疲れるのは、自分が誰で、何に取り組み、どの形式を好み、どこまで進めたのかを、毎回説明し直さなければならないことです。
MuseWorkは会話の中から、プロジェクトの背景、表現の好み、重要な制約、節目となる計画、ユーザーからのフィードバックなど、長く役立つ情報に注目します。それらを単にチャット履歴へ詰め込むのではなく、確信度を伴う異なる種類のシグナルとして記録します。
記憶は、チャット履歴を検索するだけの仕組みでもありません。MuseWorkは会話が始まる前に安定した理解を反映するため、協働が毎回ゼロから始まることはありません。
非同期の記憶エンジンが最近のシグナルを処理し、どれがより確かで、どれが古く、どれを統合し、どれを忘れるべきかを判断します。社内では、この処理を 「Dreamweaving」 と呼んでいます。
協働を重ねるたびに、次の協働が少しずつ進めやすくなるべきです。
結論
MuseWork の原則はシンプルです。複雑さはシステム側に置き、ユーザーにはシンプルさを届ける。
設定不要なのは、準備作業がユーザーを選別するべきではないからです。セッションを意識させないのは、コンテキスト管理をユーザーに任せるべきではないからです。複数チャネルを統合するのは、どこから話しかけても同じアシスタントであるべきだからです。キャッシュ、圧縮、必要時だけの実行によって、ユーザーが気兼ねなく会話できるようにします。分離と暗号化によって、「信じてください」と言うしかない領域を減らします。記憶と Dreamweaving によって、長期的な協働を途切れさせません。
AI の未来は、AI を最もうまく使える人だけのものであってはなりません。
一つの仕事をきちんと終えたい人、一つの考えを明確に伝えたい人、ある一日を少しだけ楽にしたい人にも、その未来は開かれているべきです。それが MuseWork の目指す方向です。